0
0
收藏
分享
淘帖
淘贴
举报

Meta 首个实时音频感知模型来了:20 多人同时说话也能分轨转写,每千分钟 3 美元

本文收录于「 Dify 」工具文章合集

蛙知AI测评 博主文章分类: ©著作权

文章标签 文章分类暂未分类 阅读数24

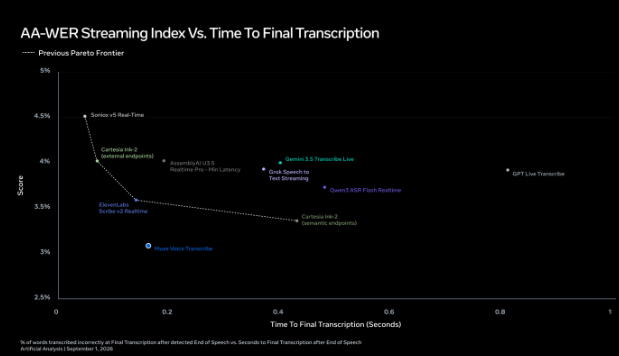
  Meta推出的Muse Voice Transcribe是首个实时音频感知模型,支持流式语音识别、说话人分离与端点检测,适用于会议记录和通话字幕等场景。该模型可处理20余名说话者的录音,并支持70余种语言,同时引入自适应延迟机制以平衡速度与准确率。

发表回复